构建一个功能完整的 AI Agent
· 技术 · AI Agent / LangGraph / MCP / RAG / Multi-Agent / Background Tasks
持续更新改进中
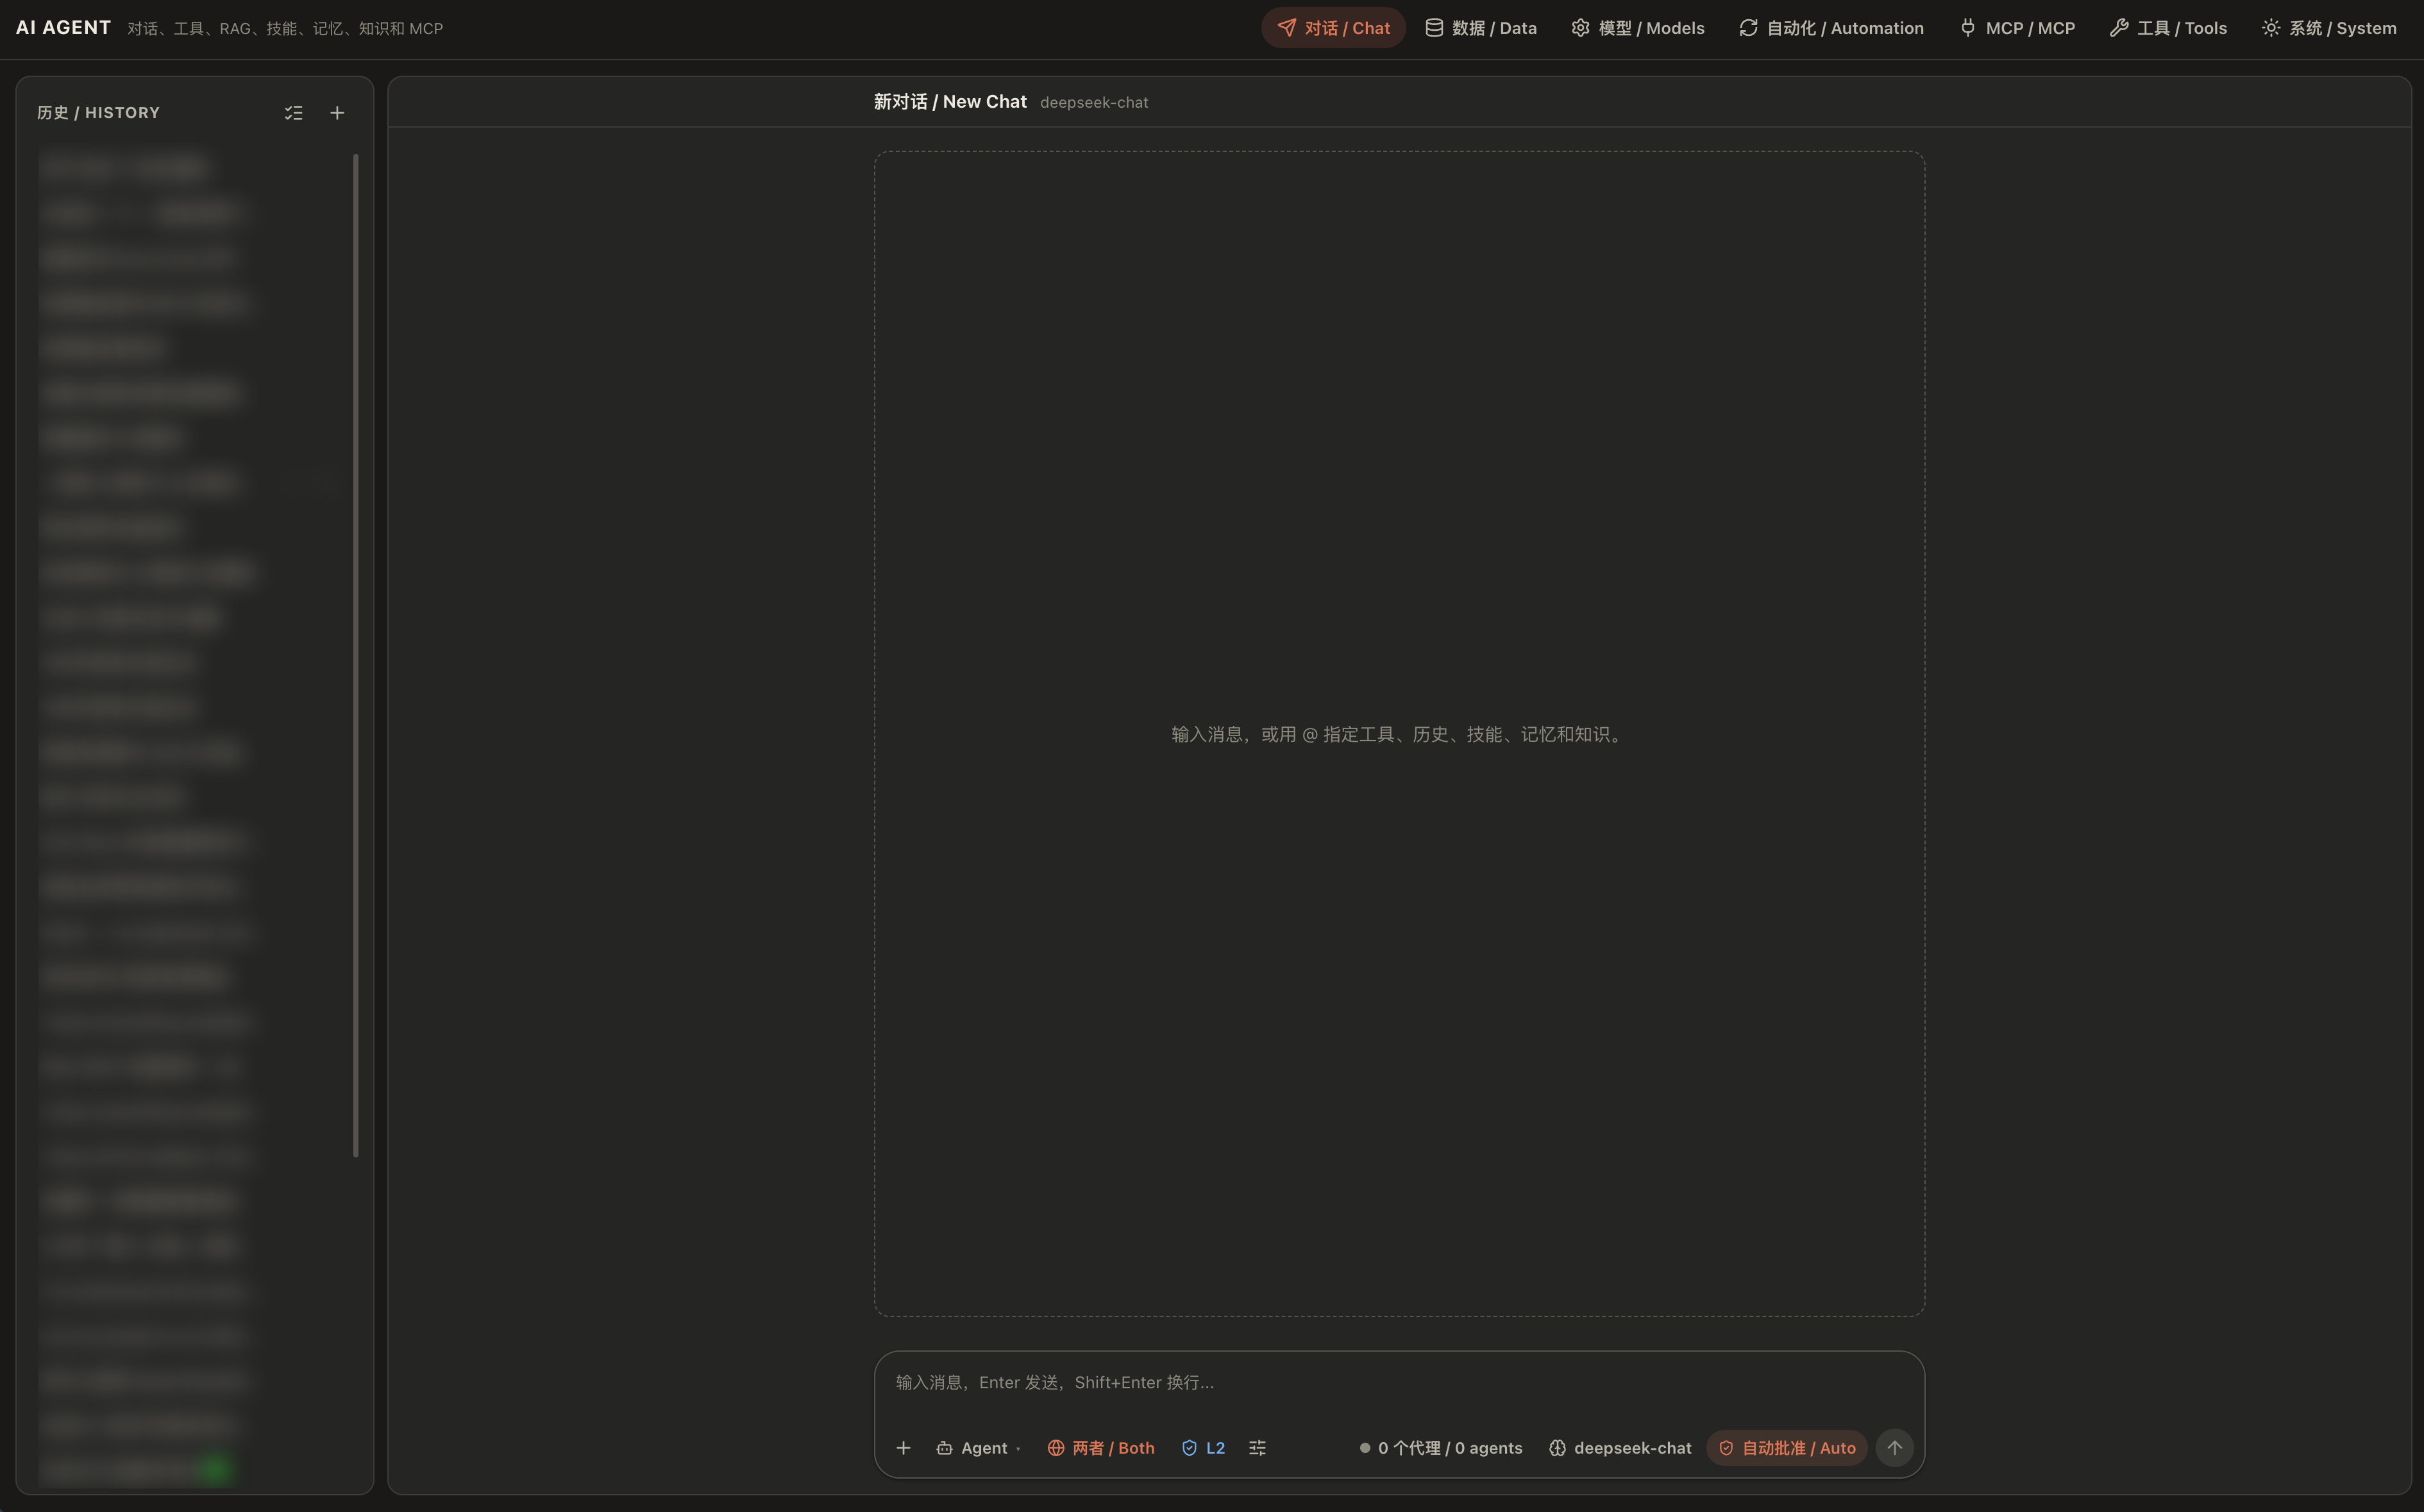
之前我做过一个带 AI 功能的租赁管理 Agent。最近重构了一部分代码,也补上了标准 MCP 等功能。过程中遇到的问题很多,值得单独记下来。
状态循环
主状态转移由 LangGraph 负责,让模型在开始对话、结束任务和调用工具等状态之间切换。
早期版本为了覆盖各种情况,堆了太多状态,甚至加入第三方 LLM 做检查。例如模型应该调用工具却直接结束时,由另一个模型拦截并要求它继续。实际效果很差,也是早期版本经常失败的原因之一。
现在的流程被压缩成几种明确状态:
- 首次进入对话:注入系统提示和必要内容。
- 开始一轮对话:加入用户问题以及可能返回的 RAG 内容。
- 模型回复:可以结束则停止;需要工具时一边回复一边调用。成功后回到对话,失败则进入错误处理。
- 停止。
- 工具调用错误:返回具体调用方法和原始错误。
- 压缩系统提示之外的上下文,可手动触发,也可在上下文过长时触发。
上下文
做 Agent 的一个直接体会是:结构越简单,通常越有效。
我曾让 AI 在每轮结束时总结前文,之后只传总结,不再传完整对话。这并没有真正省下 token,反而让模型更难理解上下文,工作质量随之下降。我也尝试在每轮都详细解释所有工具,结果同样是上下文更乱、错误更多。
现在只在内容确实过长时整体压缩,否则直接保留历史消息。这样既保证任务连续性,也能利用 LLM 的 KV cache。由于 cache 往往要求前缀完全一致,系统提示保持短且稳定,后面只给出当前可用的工具名;压缩时也不动系统提示部分。
工具调用
工具本身仍然需要严格的安全检查。调用格式则没必要自己再造一层 JSON 协议,直接使用模型原生的 tool calls 即可。整段对话开始时,只需给出工具名、输入输出和一句简洁说明。
我通常把工具分成三类:
- RAG、网络搜索等基础能力做成开关,在收到用户请求时自动取得相关内容,避免为了准备上下文而多轮调用。
- 文件读写、手动查询 RAG 等常用工具直接写进开头指令,只给简短说明;调用失败时再把具体方法和原始错误返回给模型,让它自行修正。
- 不常用工具只写进 Skill,遇到相应问题时再通过检索读取。
多 Agent
并行 Agent 有时更快,但也会引入文件修改冲突。我的流程是主 Agent 拆分任务并启动子 Agent,后台记录运行中的任务;完成后由主 Agent 检查结果,决定接受、修改或停止。
文件冲突方面,最简单可靠的办法是让各个子 Agent 先准备临时修改,再由单一进程串行写入共享文件。如果目标文件在准备期间发生变化,就把最新版重新交给 Agent 调整。
后台任务
在服务器上训练模型时,断开连接不应该让任务状态丢失。每个后台任务都要记录自己启动的程序,并明确设置为“对话关闭后退出”或“继续运行”。任务完成后,一条简单命令就能重新唤起对应对话,报告进度并执行下一步,不必靠持续轮询消耗 token。
关于 RAG
我曾经尝试用更好的 Encoder 来提升 RAG 的搜索精度,但是部署到服务器后发现速度太慢。经过学习和查阅资料,目前改用了关键词检索(BM25)加向量检索的混合方案:
- 根据文本结构,或者让更聪明的 LLM 来规划,把文档切分成 Chunk。
- LLM 结合上下文,为每个 Chunk 写一小段简短的背景说明,避免单个 Chunk 在搜索结果中丢失上下文。这一步在建立索引时完成,搜索时不需要再调用模型。
- 搜索时同时使用关键词检索和向量检索,最后综合排序。
此外,如果回答引用了 RAG 的内容,代码会检查引用的来源是否真实,不合格就让模型重新回答。
在少量的测试中,这种方法没有增加搜索时的消耗,同时确实提升了搜索精度。
关于记忆
我优化过几次记忆方案。最开始是让模型把所有记忆写入同一个文件,需要时再用 RAG 搜索,但这样会出现很多问题,例如不同记忆的真实性不同、某些记忆已经过期等。现在我采用了更结构化的方法。
记忆大致分为三类:
- 用户长期记忆:用户的背景、职业等。
- 用户短期记忆:和具体时间相关的事,例如周五临时开会。
- 经验:用什么方法避开任务报错等。
每条记忆大致有这些属性(会根据实际情况调整):
- 时间属性:发生时间、过期时间等,主要是模型创建的相对客观的属性。
- 内容属性:记忆内容、LLM 根据上下文补充的见解,以及重要性和可信度评分,这部分主观性较强。例如“用户喜欢吃薯条”,AI 发现用户可能只喜欢某一家的薯条。
- 来源属性:记忆 id、创建时间、来源(用户亲口所说、AI 总结,或后期整理出来的)等完全客观的属性。
后端会在记忆积累到一定程度后自动整理:标记过期的记忆、合并重复的记忆,并根据多条记忆生成新的见解。整理时不会直接删除记忆,只是改变它们的状态。
搜索时仍然使用 RAG,但只搜索有效的记忆,并把类型、重要性、可信度等信息一起参与检索。通过这种格式化的整理,可以相对提高记忆使用的准确性。
MCP 与自动化
MCP 可以理解为给模型使用的统一接口:后端处理协议通信,模型像调用普通工具一样调用 MCP 能力。
很多 Agent 把自动化周期写死成每天、每周或每月。其实每次任务执行完后,可以让 LLM 根据结果决定下次触发时间,甚至使用逐步拉长的间隔。
对话模式
Agent 现在有 Ask、Plan、Agent 三种模式。在 Plan 模式下,模型会先写出一份可以审阅的会话计划,我确认之后才开始实施,避免 Agent 一路跑偏。
Agent 也可以在任务中途向我提问,支持自由输入、选项、拒绝和改变方向,提问窗口可以最小化,不会挡住对话。
对话可以创建分支和编辑,Agent 工作时可以排队或插入消息,运行中的任务可以暂停和继续。
自定义工具
可复用的 Python 工具可以在 Tools 页面创建,也可以由 Agent 自己创建为 custom__name。当 Agent 发现自己在反复做同一种操作时,就可以把它做成工具。原则和之前一致:上下文里只放工具名称和一句话描述。
参数引用
工具的返回结果有时非常大,例如很长的 MCP 查询或一整个文件,全部放进上下文既浪费 token 又会让模型困惑。现在这类结果可以保存为对话范围内的参数,并通过 param:<id> 这样的 ID 引用。模型可以把引用传给下一个工具,或者只读取需要的路径或片段,而不用来回复制完整数据。
界面上还增加了当前操作的预览,显示 Agent 正在做什么、调用了哪些工具,不用再干等。
部署
Agent 现在通过 Docker 和 GitHub Actions 独立部署,与租房系统仓库解耦。容器不对外开放端口,而是加入内部 Docker 网络,租房系统的网关是唯一的公开入口,在登录检查之后再代理到 Agent。
关于权限和审核
我从不把 Agent 的权限开到完全访问,那样太危险了。目前我设计了 3 层权限和几种不同的审批方式。
权限
- L1:只能对话,以及 RAG、联网搜索等纯读取操作(具体功能可以手动关闭),不运行代码,也不能修改文件。
- L2(默认):可以使用 MCP、文件读写等全部工具,但运行代码的操作会交给没有特权的系统用户执行,并限制敏感文件和配置的修改,没有真实的系统权限。
- L3:拥有后端本身的全部权限。因为主要的使用方式是部署在 Docker 里,所以即使拿到容器内的 root 权限,问题也相对不大;但如果直接部署在本机,理论上它可以做任何事情。
需要注意的是,在没有系统级沙箱的情况下,这套机制只能降低风险,不能保证绝对安全。
审核
- 手动批准:需要修改时先暂停,把具体内容展示给我,批准后才执行。
- 自动批准:几乎所有操作都直接执行。
- AI 审核:用一个旁路的 LLM,根据用户需求和实际操作判断是否放行,主要针对高风险操作。
- 禁止所有:只读,不允许任何修改。
设置与测试
安全的系统设置可以放在 JSON 等结构化文件中,让 Agent 通过修改配置完成诸如切换系统语言之类的操作。
开发时最实用的方法之一,是直接问正在协助编程的 Codex 某个机制如何工作,再照着实现;也可以让另一个 LLM 实际操作 Agent 的功能并报告错误,问题会更容易暴露。